Dalla sequenza dell’RNA alla sintesi delle proteine
Il codice genetico è l’insieme delle regole attraverso cui la sequenza di nucleotidi contenuta nell’RNA messaggero viene interpretata per costruire una proteina.
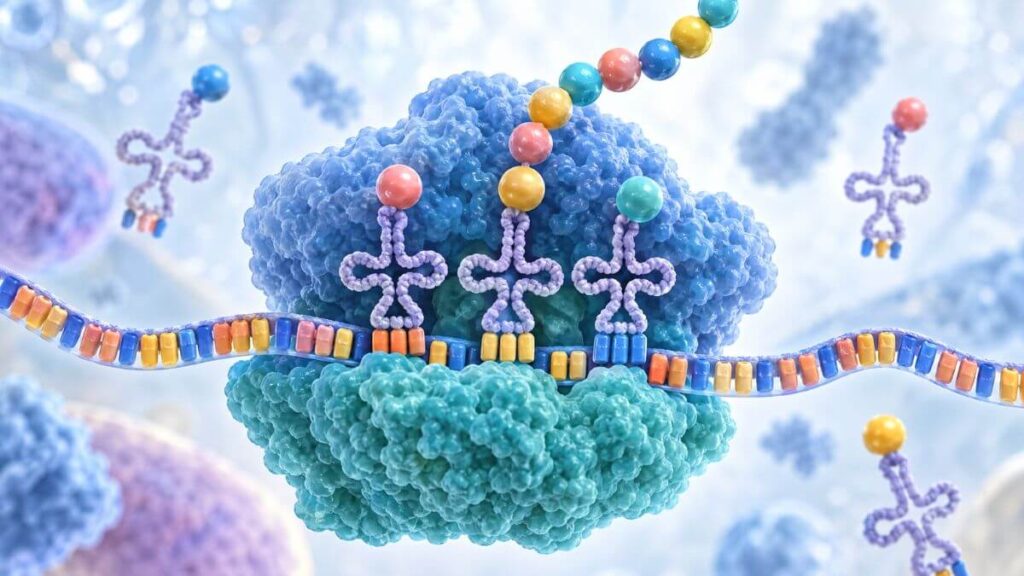
Durante la traduzione, il ribosoma legge l’mRNA in gruppi di tre nucleotidi chiamati codoni. A ciascun codone corrisponde un determinato significato: nella maggior parte dei casi un amminoacido, mentre alcuni codoni indicano l’inizio o la fine della traduzione.
Comprendere il codice genetico significa quindi capire come una sequenza composta da quattro basi azotate possa essere trasformata in una sequenza di amminoacidi.
Il concetto è centrale nella genetica molecolare e si collega direttamente a DNA, RNA messaggero, tRNA, ribosomi e sintesi proteica. Per una visione generale puoi partire anche dalla guida dedicata alla genetica e agli argomenti fondamentali da studiare.
Che cos’è il codice genetico?
Il codice genetico mette in relazione la sequenza nucleotidica dell’RNA messaggero con la sequenza degli amminoacidi che formeranno una proteina.
L’mRNA utilizza quattro basi azotate:
- adenina, A;
- uracile, U;
- guanina, G;
- citosina, C.
Poiché le basi vengono lette a gruppi di tre, il numero totale delle combinazioni possibili è 4 × 4 × 4 = 64 codoni. Di questi:
- 61 specificano amminoacidi;
- 3 funzionano normalmente come segnali di stop.
I tre codoni di stop sono:
- UAA;
- UAG;
- UGA.
Questi non codificano normalmente per un amminoacido nel codice genetico standard, ma segnalano la terminazione della traduzione.
Che cos’è un codone?
Un codone è una sequenza di tre nucleotidi consecutivi dell’RNA messaggero. Per esempio AUG è un codone formato da adenina, uracile e guanina. Nel codice genetico standard AUG specifica l’amminoacido metionina e svolge anche una funzione fondamentale nell’avvio della traduzione.
Perché i codoni sono formati da tre basi?
Con due sole basi per unità di lettura avremmo 4² = 16 combinazioni che non sarebbero sufficienti a specificare i 20 amminoacidi standard.
Con triplette di basi, invece, abbiamo 4³ = 64 combinazioni un numero sufficiente per codificare tutti gli amminoacidi e includere anche segnali di terminazione.
Come si legge il codice genetico?
Per utilizzare correttamente una tabella del codice genetico bisogna ricordare un punto essenziale si leggono i codoni dell’mRNA nella direzione 5′ → 3′.
Consideriamo questa breve sequenza: 5′-AUG-GGC-UUU-UAA-3′. La lettura procede per triplette:
- AUG;
- GGC;
- UUU;
- UAA.
Nel codice genetico standard queste corrispondono a:
- AUG → metionina;
- GGC → glicina;
- UUU → fenilalanina;
- UAA → stop.
La sequenza prodotta sarà quindi, in forma semplificata Metionina – Glicina – Fenilalanina. UAA non aggiunge un ulteriore amminoacido, ma determina la terminazione.
Attenzione a DNA e RNA
Le tabelle standard del codice genetico vengono generalmente presentate utilizzando i codoni dell’RNA messaggero, quindi contengono uracile, U, e non timina, T.
Se un esercizio fornisce una sequenza di DNA, prima di utilizzare la tabella bisogna capire se si tratta del filamento codificante o del filamento stampo e ricavare correttamente la sequenza dell’mRNA.
Puoi approfondire questo passaggio nell’articolo dedicato al ruolo dell’RNA messaggero.
Codone di inizio: perché AUG è importante?
Il codone AUG ha una doppia funzione. Nel codice genetico standard:
- codifica per la metionina;
- quando viene riconosciuto nel corretto contesto di inizio, contribuisce a definire il punto da cui parte la traduzione.
Questo secondo ruolo è fondamentale perché stabilisce anche il quadro di lettura.
Consideriamo una sequenza ipotetica: AUGGCCAAA…
Se la lettura parte dal primo nucleotide AUG | GCC | AAA si ottengono determinati codoni. Spostando invece la suddivisione di una sola base UGG | CCA | … i codoni cambiano completamente.
Per questo individuare correttamente il punto di inizio è indispensabile per interpretare la sequenza.
Quali sono i codoni di stop?
I tre principali codoni di stop del codice genetico standard sono UAA, UAG e UGA.
Quando uno di questi codoni raggiunge il ribosoma nel corretto quadro di lettura, non viene normalmente riconosciuto da un tRNA che trasporta un amminoacido.
Intervengono invece specifici fattori di rilascio, che favoriscono la terminazione della sintesi della catena polipeptidica.
La proteina nascente viene quindi liberata e il complesso di traduzione può dissociarsi.
Qual è la differenza tra codone e anticodone?
Codone e anticodone sono due triplette complementari che appartengono però a molecole diverse.
| Codone | Anticodone |
|---|---|
| Si trova sull’mRNA | Si trova sul tRNA |
| Viene letto dal ribosoma | Si appaia al codone |
| Specifica un significato nel codice genetico | Contribuisce al riconoscimento del codone da parte del tRNA |
Se il codone dell’mRNA è 5′-AUG-3′ il relativo anticodone complementare può essere rappresentato come 3′-UAC-5′.
Il tRNA porta inoltre l’amminoacido appropriato, che nel caso di AUG è la metionina.
Per approfondire questo meccanismo puoi leggere l’articolo dedicato all’anticodone e al suo meccanismo d’azione.
Come fa il tRNA a portare l’amminoacido corretto?
L’appaiamento codone-anticodone è fondamentale, ma da solo non spiega tutta la precisione della traduzione. Prima che il tRNA raggiunga il ribosoma, deve essere associato al corretto amminoacido.
Questo compito è svolto dalle aminoacil-tRNA sintetasi, enzimi che riconoscono specifici tRNA e catalizzano il legame con l’amminoacido appropriato.
Il sistema deve quindi funzionare correttamente a due livelli:
- il tRNA deve essere caricato con l’amminoacido corretto;
- il suo anticodone deve riconoscere il codone appropriato sull’mRNA.
Questa doppia selezione contribuisce all’accuratezza della sintesi proteica.
Perché il codice genetico è degenerato?
Una delle caratteristiche più importanti del codice genetico è la sua degenerazione, detta anche ridondanza.
Significa che più codoni differenti possono specificare lo stesso amminoacido.
Per esempio, la leucina è codificata da più codoni differenti. Questo è possibile perché esistono 61 codoni con significato amminoacidico ma soltanto 20 amminoacidi standard utilizzati normalmente nella sintesi proteica.
Degenerato non significa ambiguo
I due concetti non devono essere confusi. Il codice genetico è degenerato perché uno stesso amminoacido può essere specificato da più codoni.
È invece definito non ambiguo perché, nel codice standard, un determinato codone specifica un solo significato amminoacidico durante la traduzione ordinaria.
In altre parole più codoni → stesso amminoacido è possibile.
Ma un singolo codone non indica normalmente due amminoacidi diversi nello stesso codice e nello stesso contesto di traduzione.
Il codice genetico è ridondante o degenerato?
I termini ridondante e degenerato vengono spesso utilizzati per descrivere la stessa caratteristica: la presenza di codoni sinonimi che specificano uno stesso amminoacido. Questa proprietà ha importanti conseguenze biologiche.
Una sostituzione nucleotidica può, per esempio, trasformare un codone in un altro che specifica comunque lo stesso amminoacido. In questo caso si parla di variante sinonima o, nella terminologia tradizionale, di mutazione silente.
La degenerazione del codice genetico contribuisce quindi a spiegare perché non ogni variazione di una base determini automaticamente una variazione nella sequenza della proteina.
Che cos’è il wobble o vacillamento?
Il rapporto tra codoni e tRNA è reso più flessibile dal fenomeno chiamato wobble o vacillamento.
L’appaiamento tra codone e anticodone è particolarmente rigoroso nelle prime due posizioni del codone, mentre nella terza posizione può essere consentita una maggiore flessibilità. Questo permette ad alcuni tRNA di riconoscere più di un codone sinonimo.
La cellula non deve quindi necessariamente possedere un tipo completamente distinto di tRNA per ciascuno dei 61 codoni che specificano amminoacidi. Il wobble contribuisce così all’efficienza della traduzione e si collega direttamente alla degenerazione del codice genetico.
Perché il codice genetico viene definito quasi universale?
Un’altra caratteristica fondamentale è la grande conservazione del codice genetico tra gli organismi. Nella maggior parte dei sistemi biologici gli stessi codoni specificano gli stessi amminoacidi.
Questa caratteristica viene spesso descritta affermando che il codice genetico è universale. Dal punto di vista scientifico è però più preciso parlare di codice genetico quasi universale, perché esistono alcune eccezioni.
Le eccezioni al codice genetico standard
Codici leggermente differenti si osservano, per esempio:
- nei mitocondri;
- in alcuni microrganismi;
- in specifici sistemi biologici.
In questi casi determinati codoni possono avere un significato differente rispetto a quello previsto dalla tabella standard. Questo non elimina l’importanza dell’universalità del codice: mostra piuttosto che la sua conservazione è molto ampia, ma non assoluta.
Codice genetico e sintesi proteica: come avviene la traduzione?
Il codice genetico viene utilizzato concretamente durante la traduzione. Il processo coinvolge:
- mRNA;
- ribosomi;
- tRNA;
- amminoacidi;
- aminoacil-tRNA sintetasi;
- fattori di inizio, allungamento e terminazione.
In termini semplificati:
- il ribosoma si associa all’mRNA;
- viene individuato il corretto sito di inizio;
- i codoni vengono letti nella direzione 5′ → 3′;
- i tRNA riconoscono i codoni attraverso gli anticodoni;
- gli amminoacidi vengono progressivamente uniti;
- la traduzione termina quando viene incontrato un codone di stop.
Per approfondire l’intero meccanismo puoi leggere la guida sulla sintesi proteica e sulla traduzione dell’mRNA.
Un esempio completo: dal DNA all’amminoacido
Consideriamo ora un esempio che permette di collegare DNA, mRNA e codice genetico. Supponiamo che il filamento codificante del DNA presenti 5′-ATG-GGC-TTT-TAA-3′.
L’mRNA corrispondente avrà la stessa sequenza del filamento codificante, sostituendo la timina con l’uracile 5′-AUG-GGC-UUU-UAA-3′. Utilizzando il codice genetico otteniamo:
- AUG → metionina;
- GGC → glicina;
- UUU → fenilalanina;
- UAA → stop.
La catena prodotta sarà quindi Met – Gly – Phe. L’esempio mostra perché sia importante distinguere sempre:
- filamento di DNA;
- RNA messaggero;
- codone;
- anticodone;
- amminoacido.
Che cosa succede se cambia un codone?
Il codice genetico permette anche di comprendere immediatamente gli effetti possibili di una variazione nella sequenza del DNA. Supponiamo che un codone dell’mRNA cambi in seguito a una sostituzione nucleotidica. Possono verificarsi scenari differenti.
Variante sinonima
Il nuovo codone specifica lo stesso amminoacido. La sequenza proteica non cambia in quella posizione.
Mutazione missenso
Il nuovo codone specifica un amminoacido differente. La proteina avrà quindi una sostituzione nella propria sequenza.
Mutazione nonsenso
Il nuovo codone diventa un codone di stop. La traduzione può quindi interrompersi prematuramente.
Questo collegamento rende evidente perché conoscere il codice genetico sia essenziale anche per comprendere le conseguenze delle mutazioni genetiche.
Il codice genetico e il quadro di lettura
La sequenza nucleotidica deve essere suddivisa nelle triplette corrette.
Consideriamo AUGGCUACCAAA. Nel corretto frame di lettura AUG | GCU | ACC | AAA. Se la lettura venisse spostata di una base UGG | CUA | CCA | … cambierebbero tutti i codoni successivi.
Questo aiuta a comprendere perché inserzioni o delezioni di un numero di nucleotidi non multiplo di tre possano provocare un frameshift, cioè uno spostamento del quadro di lettura.
Come usare una tabella del codice genetico
Le tabelle del codice genetico possono avere una struttura differente, ma il principio è sempre lo stesso: partire dal codone dell’mRNA e individuare l’amminoacido corrispondente.
Prima di utilizzarle verifica sempre:
- che la sequenza sia RNA e non DNA;
- che sia scritta nella direzione 5′ → 3′;
- che il frame di lettura sia corretto;
- che le triplette siano state suddivise correttamente;
- che eventuali codoni di stop non vengano interpretati come amminoacidi.
Un esempio rapido
Codone 5′-UGG-3′. Nella tabella standard corrisponde al triptofano.
Non bisogna trasformarlo nel suo anticodone prima di consultare la tabella, a meno che l’esercizio non chieda espressamente di ricavare il tRNA corrispondente.
Errori frequenti sul codice genetico
Quando si studia il codice genetico, alcuni errori ricorrono frequentemente.
- confondere codone e anticodone;
- utilizzare direttamente una sequenza di DNA in una tabella costruita per l’mRNA;
- leggere la sequenza nella direzione sbagliata;
- dimenticare che i codoni sono triplette;
- considerare AUG soltanto come codone della metionina senza riconoscerne il ruolo nell’inizio;
- considerare i codoni di stop come codoni per un amminoacido;
- confondere degenerazione con ambiguità;
- affermare che il codice genetico è assolutamente universale senza considerare le eccezioni;
- pensare che ogni sostituzione di nucleotide debba necessariamente modificare la proteina.
Domande frequenti sul codice genetico
Che cos’è il codice genetico?
È l’insieme delle regole che mette in relazione i codoni dell’RNA messaggero con gli amminoacidi incorporati durante la sintesi proteica e con i segnali di terminazione.
Quanti codoni esistono?
Esistono 64 possibili triplette formate dalle quattro basi dell’RNA. Nel codice genetico standard, 61 specificano amminoacidi e tre sono codoni di stop.
Qual è il codone di inizio?
AUG è il principale codone di inizio nel codice genetico standard e codifica per la metionina. Il suo ruolo come start dipende però dal contesto di inizio della traduzione.
Quali sono i codoni di stop?
I tre codoni di stop standard sono UAA, UAG e UGA.
Qual è la differenza tra codone e anticodone?
Il codone è una tripletta dell’mRNA. L’anticodone è una tripletta del tRNA che si appaia in modo complementare e antiparallelo al codone durante la traduzione.
Perché il codice genetico è degenerato?
Perché più codoni differenti possono specificare lo stesso amminoacido.
Perché il codice genetico non è ambiguo?
Perché nel codice standard un determinato codone possiede normalmente un solo significato amminoacidico durante la traduzione ordinaria, anche se lo stesso amminoacido può essere specificato da codoni differenti.
Il codice genetico è universale?
È altamente conservato e viene spesso definito universale, ma esistono alcune eccezioni. È quindi più preciso parlare di codice genetico quasi universale.
Codice genetico e DNA sono la stessa cosa?
No. Il DNA è la molecola che conserva l’informazione genetica. Il codice genetico è invece il sistema di corrispondenze utilizzato durante la traduzione per interpretare i codoni dell’mRNA.
Codice genetico: cosa ricordare
Il codice genetico permette di trasformare l’informazione contenuta nella sequenza nucleotidica dell’RNA messaggero in una sequenza di amminoacidi.
L’mRNA viene letto in triplette chiamate codoni. Esistono 64 codoni possibili: 61 specificano amminoacidi nel codice standard e 3 funzionano come segnali di stop.
Il codice genetico è degenerato, perché più codoni possono specificare lo stesso amminoacido, ma è non ambiguo nel senso che uno stesso codone possiede normalmente un solo significato nel codice standard.
È inoltre altamente conservato tra gli organismi, pur presentando alcune eccezioni che rendono più corretto definirlo quasi universale.
Per comprenderlo davvero, non limitarti a memorizzare la tabella dei codoni. Impara a distinguere DNA, mRNA, codone, anticodone e amminoacido e prova a ricostruire il percorso dell’informazione genetica fino alla proteina. Puoi continuare lo studio approfondendo il ruolo dell’RNA messaggero, il meccanismo dell’anticodone e il processo completo della sintesi proteica.